HeatTrip
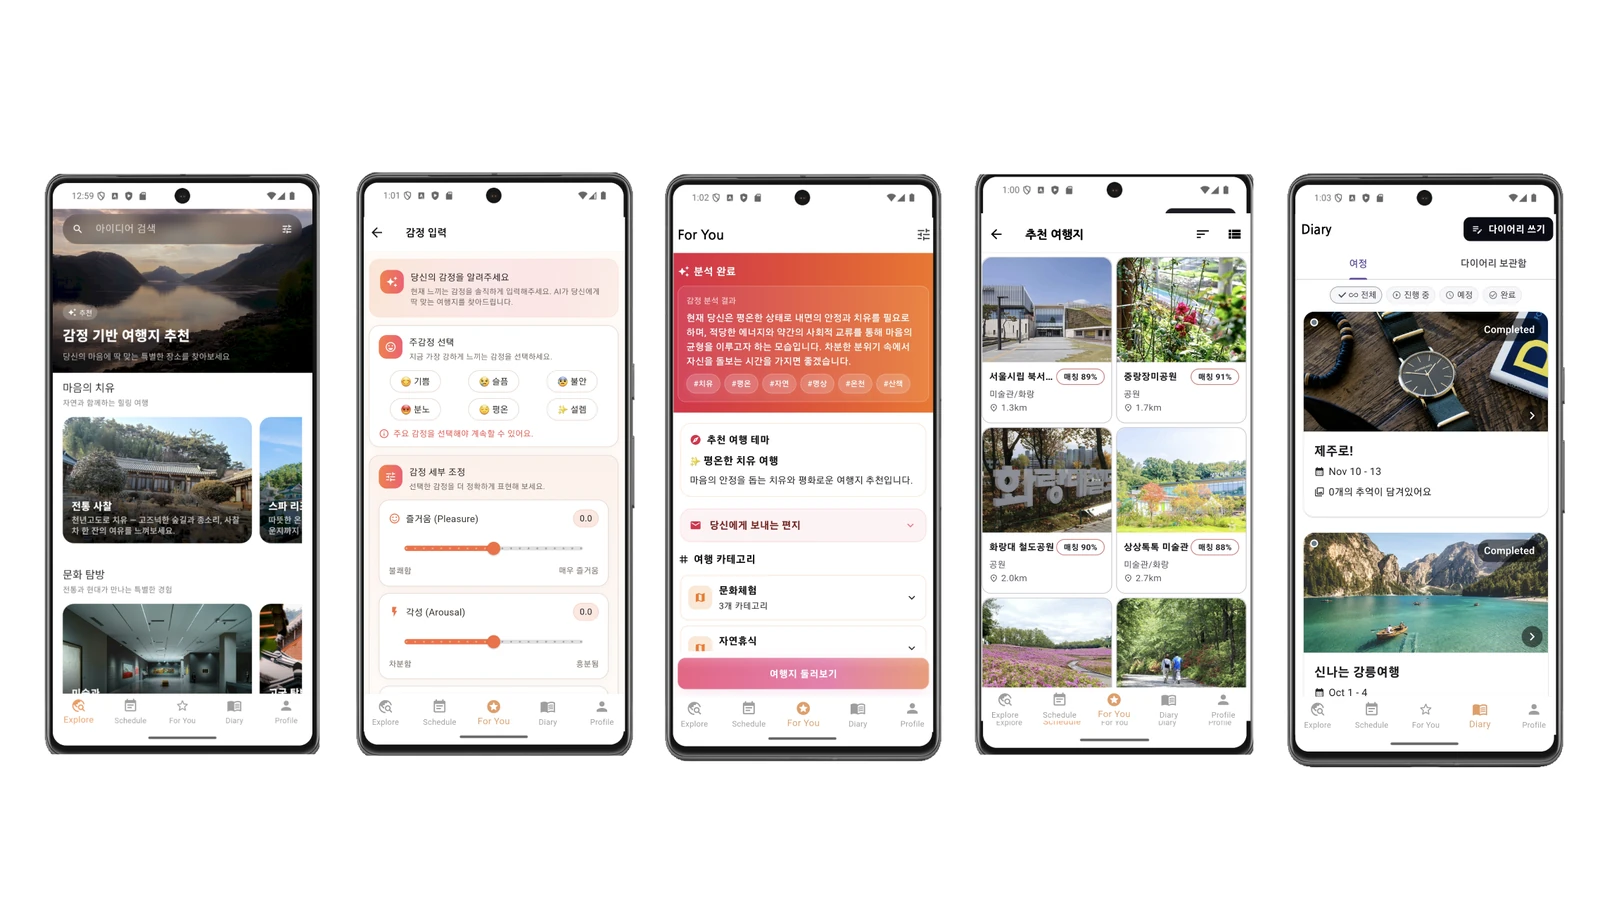
감정 입력(감정 칩, PAD 슬라이더, 에너지, 사교성, 여행 목표)으로 한국관광공사 장소 데이터에서 여행지를 추천하고 일정·다이어리로 잇는 모바일 여행 서비스입니다. 2025 관광데이터 활용 공모전 3인 팀의 팀 리드로 기획, 서버의 장소 수집·탐색·추천·미디어·인증, Python 추천 서버, 앱의 추천·탐색 화면, 배포와 원스토어 출시를 맡았습니다. 2026년 3–6월에는 서버를 혼자 다시 정비했습니다. 서버는 2026-10 현재 운영하지 않습니다.
Role
3인 팀 리드 — 기획, 백엔드(장소 수집·탐색·추천·미디어·인증), Python 추천 서버, 앱 추천·탐색 화면, 배포·원스토어 출시
Period
2025.07–11 공모전(팀 Hit다Heat, 3인) · 2026.03–06 개인 리팩토링
약 5만 곳
수집한 관광공사 장소
로컬 DB 50,098건 기준(2026-10-01)
95개
LLM이 고르는 카테고리 목록
닫힌 목록 · 장소 목록은 프롬프트에 넣지 않음
일정 API·다이어리 v1은 팀원 A가, 북마크·프로필은 팀원 B가 만들었습니다. 앱은 원스토어에 1.0.0을 2025-09-15에 등록했고, 1.0.0(3)을 2025-10-23에 다시 올렸습니다.
팀과 맡은 범위
2025 팀 시기 기준입니다. 서버는 패키지, 앱은 기능 단위로 적었습니다.
| 영역 | 본인 | 팀원 A | 팀원 B |
|---|---|---|---|
| 기획 | 팀 리드(기획·총괄) | 풀스택 개발 | 풀스택 개발 |
| 서버 | 장소 수집·보강(tour, kakao), 탐색·검색(explore), 추천(curation), 미디어(S3), 인증(OAuth, user 대부분), 다이어리 v2 API, 배포 설정 | 일정 CRUD, 다이어리(journey) 엔티티·v1 API | 북마크·컬렉션, 회원 정보 수정·탈퇴, 의견 보내기 |
| 추천 서버 | Python(FastAPI) 전부 | — | — |
| 앱 | For You v1·v2, Explore 대부분, 인증·기록·미디어, 배포 빌드 | 다이어리 일부 | 북마크·프로필, 다이어리 화면 일부, Explore 일부, 디자인 수정 |
| 배포·출시 | Dockerfile·compose(2025-09-12), 원스토어 등록(판매자 본인) | — | — |
시스템 구성
- 장소 데이터는 서버가 모으고, 장소 상세의 ‘개요’는 앱이 관광공사 API를 직접 부릅니다.
- 추천 LLM은 별도 Python 서버에 있고, Spring은 그 결과를 장소 순위로 바꿉니다. 대가는 요청 경로에 동기 호출이 한 단계 늘고, 그동안 톰캣 스레드가 기다린다는 점입니다.
추천: LLM이 고르는 것과 Spring이 하는 것
장소 목록은 프롬프트에 넣지 않습니다. LLM은 95개 카테고리 이름 중에서 골라 두 그룹으로 묶어 돌려줍니다. 출력이 닫힌 목록이라, Spring은 메모리에 올린 카테고리 사전(place_traits 95행)으로 라벨을 cat3 코드로 바꿔 장소를 거릅니다. 대가로 사전에 없는 라벨은 버려지고, 매핑이 비면 장소 전체를 읽습니다(findAll()).
순위는 LLM이 아니라 Spring의 점수식이 정합니다. 최종 점수는 0.6×특성 일치 + 0.4×인기도입니다. 앱이 위치를 보내면 거리 점수를 0.2 비중으로 섞습니다. 상수는 손으로 정했고, 데이터로 검증한 기록은 없습니다.
추천 서버가 LLM 출력의 형식을 검증하고 고칩니다. 응답은 JSON 모드로 받아 Pydantic으로 검증하고, 실패하면 재요청, 위로 편지 보정, 정규화 순으로 처리합니다. 같은 입력은 5분 동안 캐시합니다. 캐시는 프로세스 메모리에 있어 인스턴스 하나를 전제로 합니다.
공모전 제출본(2025-09-19 제출)은 LLM이 없는 v1(2025-09-10, b6fac1c)입니다. v1은 전체 장소에 점수를 매기고, 감정 카테고리 18개(매핑 72개)로 묶어 보여 줬습니다. LLM을 쓰는 v2는 2025-10-18(58da1b9)에 들어와 스토어 1.0.0(3)에 실렸습니다. 두 판은 같은 ScoringService를 씁니다.
장소 데이터: 수집과 모델
- 수집. 관광공사 지역 목록(
areaBasedList2)을 받아 정제·절단(Place.sanitizeAndTruncate)한 뒤 배치로 저장합니다. 저장 뒤에는 두 작업이 갈라집니다. 하나는 Kakao Local로 링크와 좌표를 보강하는 작업이고(속성 플래그로 한 번 실행), 다른 하나는 CAT3 특성 스냅숏을 만들어 2026년부터search_text를 채우는 작업입니다. 스케줄러는 주석 처리돼 있어 수동으로 돌리고, 실행 이력은 남기지 않습니다. - 규모. 장소는 50,098곳(이미지 있는 곳 38,871)입니다. 카테고리 사전은 95행, 감정 카테고리는 18개(매핑 72개)입니다.
- 키. 장소 쪽 표는 FK 없이
contentid와cat3로 잇습니다. 스키마는 Hibernateddl-auto로 관리하고(마이그레이션 도구 없음), FULLTEXT 인덱스는 수동 SQL로 만듭니다. - 무한 스크롤.
(createdtime, contentid)커서를 Base64URL 토큰으로 주고받고, size+1개를 읽어 다음 페이지가 있는지 판단합니다.contentid를 둘째 키로 둬 같은 시각 행의 중복·누락을 막습니다. 목록 화면은 오프셋을 그대로 씁니다. 대가로 커서를 받칠 복합 인덱스 DDL이 레포에 없습니다. - 미디어. DB에는 S3 키만 저장하고, URL은 CloudFront 도메인과 키로 실행 때 만듭니다. 어디에 붙는 파일인지는
ref_type/ref_id로 적고(FK 아님), 삭제는 소프트 삭제입니다.
2026 개인 리팩토링
2026-03-19부터 06-18까지 혼자, 공개 저장소와 운영을 기준으로 서버를 다시 정비했습니다.
| 영역 | 바꾼 것(커밋) | 대가 |
|---|---|---|
| 공개 운영 정비 | /api/curation/**에 인증 요구, 인증 없이 열어 둔 경로 축소, 경로별 레이트 리밋(메모리 고정 윈도), gitleaks 비밀 스캔(934caca) | 이미 배포된 1.0.0(3)은 토큰을 보내지 않아 For You가 302로 실패하게 됨. 하위 호환은 확인하지 않음 |
| 검색 | EXPLAIN ANALYZE로 count 쿼리의 전체 스캔과 상관 서브쿼리 반복을 확인. 검색할 문자열을 search_text 컬럼 하나로 반정규화하고 FULLTEXT(ngram) 인덱스와 MATCH … AGAINST … IN BOOLEAN MODE로 전환(0a72056) | 결과가 LIKE와 다름(한 글자, 특수문자). 정렬은 관련도가 아니라 contentid 순 |
| 추천 호출 분리·테스트·관측성 | 추천 서버 호출을 Kotlin 포트/어댑터로 옮기고(12d351c, 2026-04-19) Kotlin DTO와 단위 테스트 추가. 요청 로그·에러 알림 AOP, correlation id, 마스킹. 에러는 fingerprint로 중복을 억제해 Slack으로 보내고 Spring AI 요약을 붙일 수 있음 | 검색·LLM DTO 테스트 일부는 변경을 되돌려도 통과. 관측성 코드는 테스트와 실제 발송 기록이 없음 |
검색의 변경 전 count는 약 755ms, 변경 후 목록은 약 4.9ms(‘카페’ 1회 측정)이고, 두 수치는 서로 다른 쿼리의 것입니다. 검색은 2025-09 팀 시기에 포트/어댑터로 떼어 두었기 때문에(df3044f) 저장소 쪽만 바꿔 전환했습니다.
앱도 하단 탭을 오늘·탐색·[기록]·피드·나로 바꾸고 감정 체크인과 피드를 더했지만 배포하지 않았습니다. 아래는 2026-10-01에 로컬 백엔드와 데모 데이터로 실행해 캡처한 화면입니다.
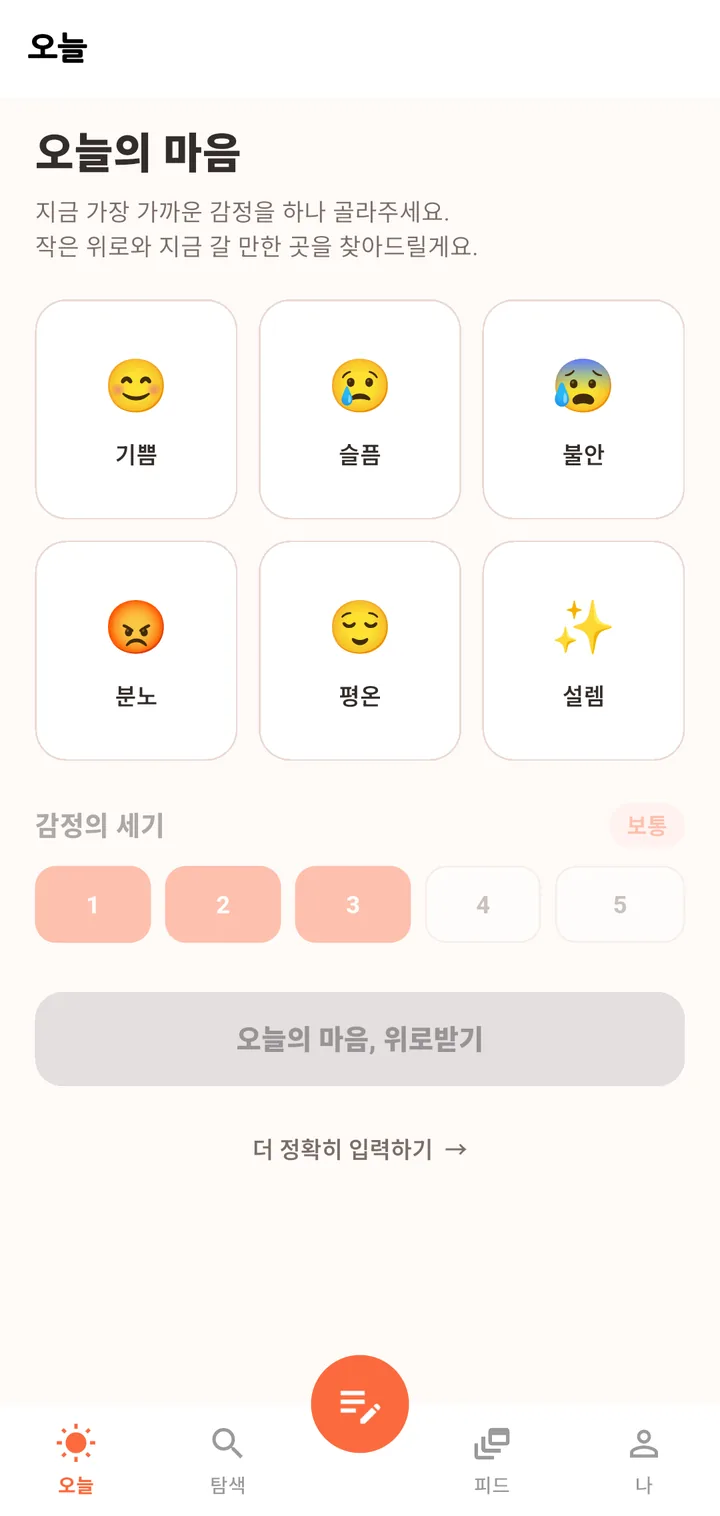
오늘 · 감정 체크인
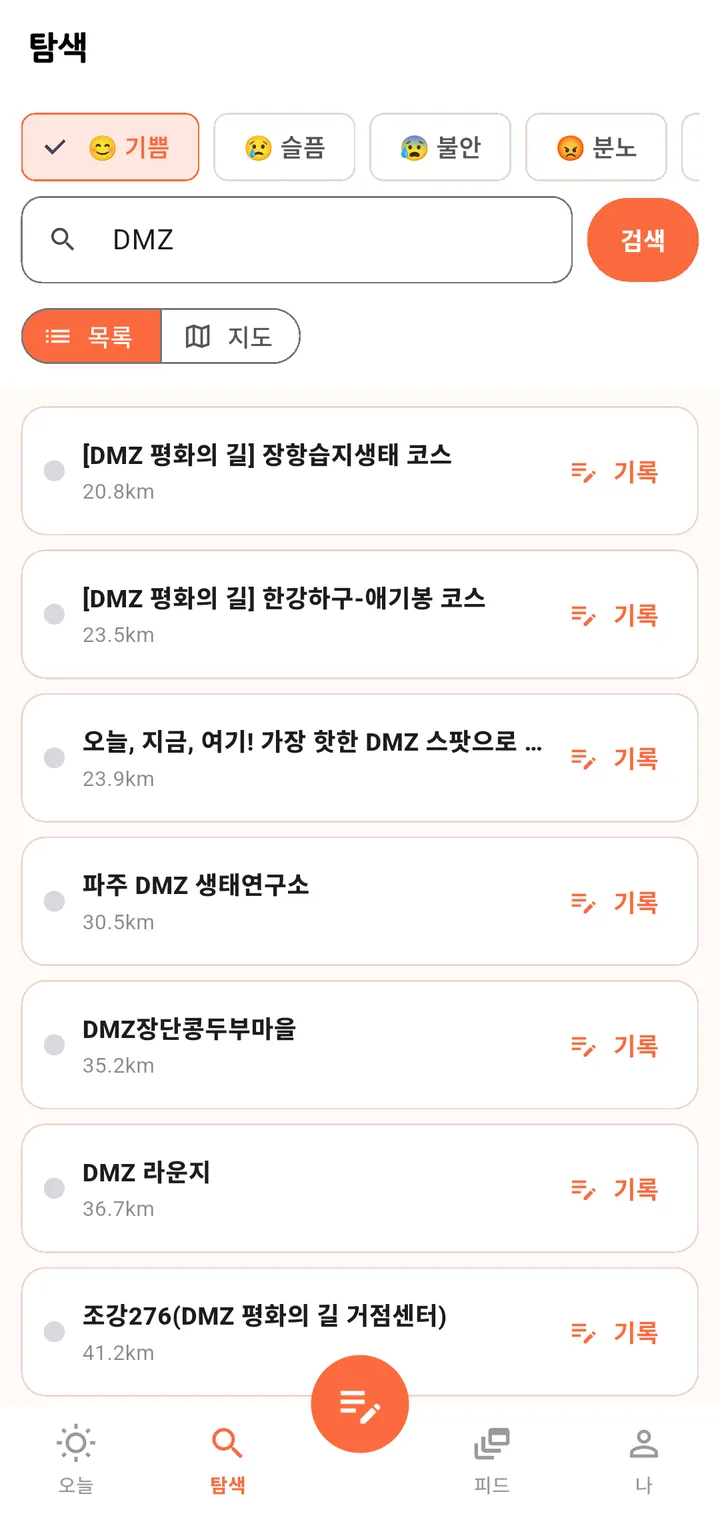
탐색 · 검색 목록
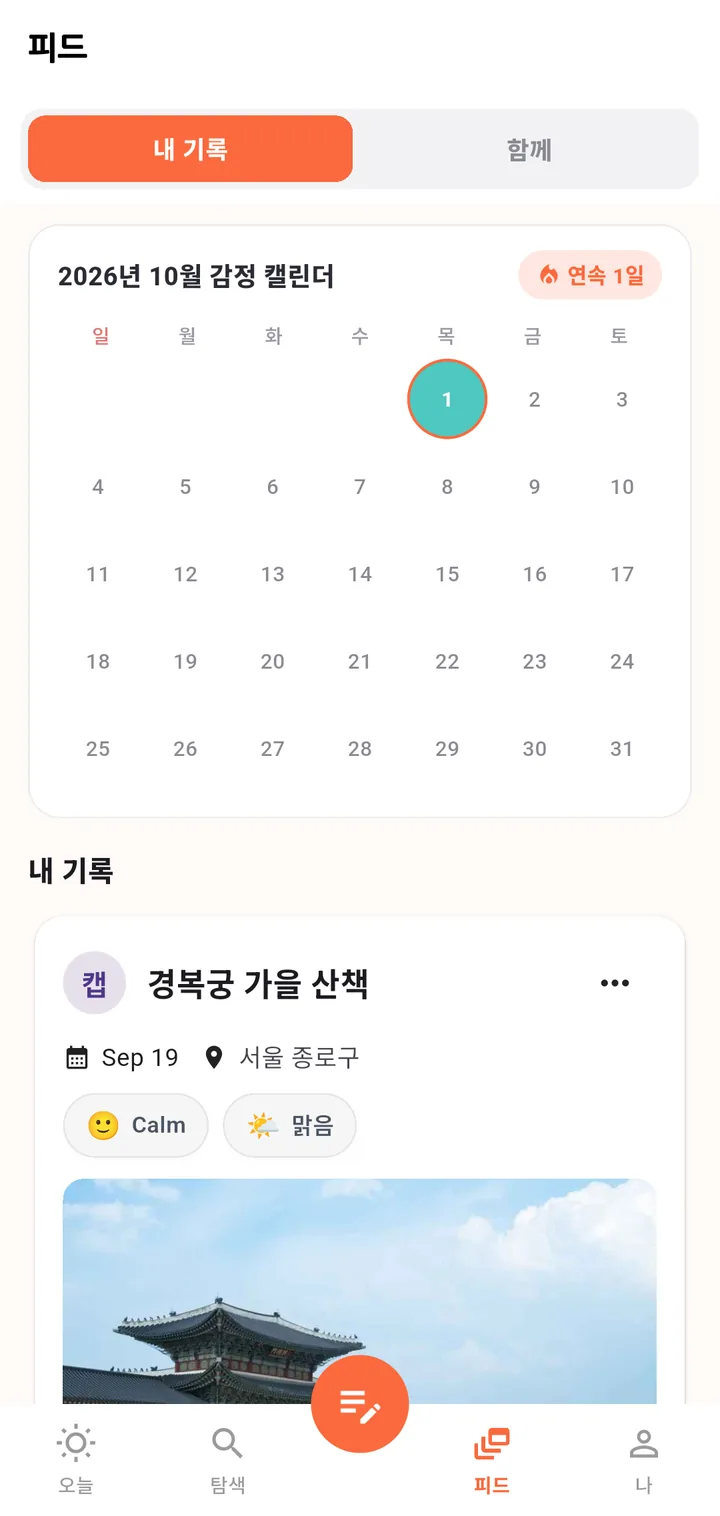
피드 · 내 기록
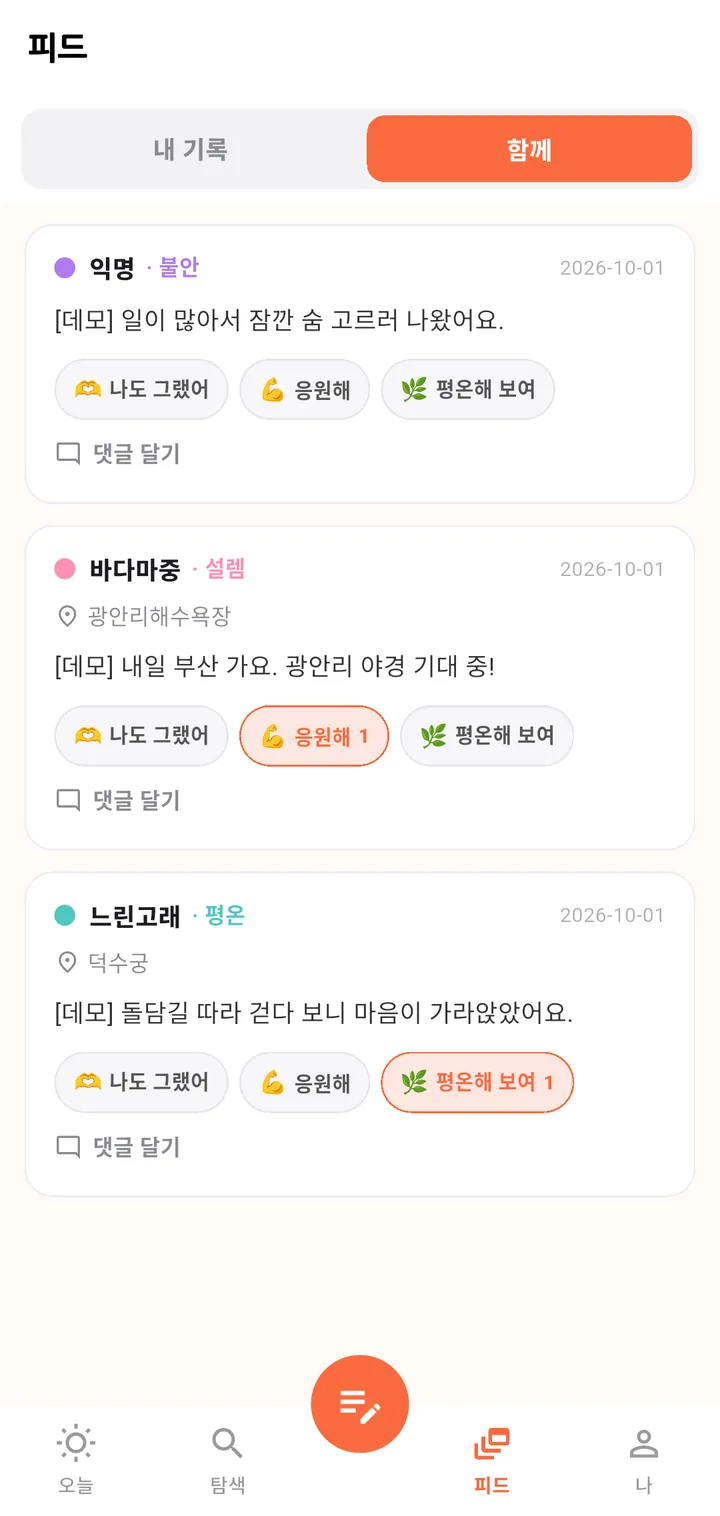
피드 · 함께
한계(고친다면)
| 한계 | 영향 | 고친다면 |
|---|---|---|
| 감정 값(PAD·에너지)을 서버 DTO가 정수로 받습니다 | 소수 입력이 대부분 0이 되어, 순위와 LLM 입력에 감정 특성이 거의 반영되지 않습니다. LLM에 온전히 가는 입력은 감정 칩, 목표 키워드, 사교성뿐입니다 | 실수 타입으로 바꾸고 앱–서버 계약 테스트를 둡니다 |
추천 서버 호출: 180초 타임아웃이 재시도마다 걸리고 4xx도 재시도하며, 톰캣 스레드가 .block()으로 기다리고 대체 응답이 없습니다 | 추천 서버나 OpenAI가 느리면 요청 스레드가 오래 묶이고 추천이 실패합니다 | 짧은 타임아웃, 4xx 재시도 제외, 규칙 기반(v1) 대체 응답을 둡니다 |
매핑이 비면 장소 전체를 읽고(findAll()), 커서를 받칠 복합 인덱스 DDL이 없으며, 스키마는 ddl-auto입니다 | 큰 표를 통째로 읽거나 정렬하는 쿼리가 생깁니다 | 빈 매핑은 빈 결과로 돌려주고, 인덱스와 스키마는 마이그레이션으로 관리합니다 |
| 테스트가 회귀를 잡지 못합니다(되돌려도 통과). 관측성 코드는 테스트·발송 기록이 없습니다 | 바꾼 뒤 안전한지 테스트로 알 수 없습니다 | 되돌리면 실패하는 테스트부터 씁니다 |
공개 앱 main이 컴파일되지 않습니다(스토어 빌드는 5313bc7, 복구 PR #9 열림) | 링크한 main으로는 출시 앱을 다시 빌드할 수 없습니다 | PR #9를 병합합니다 |
백엔드와 앱 코드는 공개되어 있고, Python 추천 서버는 비공개입니다. 서버는 2026-10 현재 운영하지 않고, 원스토어 등록 기록만 남아 있습니다. 2026-09-30 이후 레포의 정리 커밋(README, 설정 클래스 등)은 AI 코딩 에이전트가 작성했고 트레일러로 표기했습니다. 2026-06의 앱 재설계 시도는 공개 레포에 없고, 이후 Pawloop으로 이어졌습니다.